RIM·iRIM: 렌즈 배열 영상의
각도 정보를 공간 해상도로
렌즈 배열 영상의 픽셀을 보간 없이 일대일로 재배열해 시점 영상을 만들고(RIM), 거꾸로 다시점 영상에서 가상 렌즈 배열 요소 영상을 합성합니다(iRIM). 연구 페이지의 실험실에서 2단계 "재배열"이 RIM입니다.
한눈에 보기
ICCAS 2026 논문의 블렌더 장면을 논문의 렌더링 스크립트로, 시점 수와 해상도만 바꿔 8×8 카메라 위치에서 렌더링했습니다.
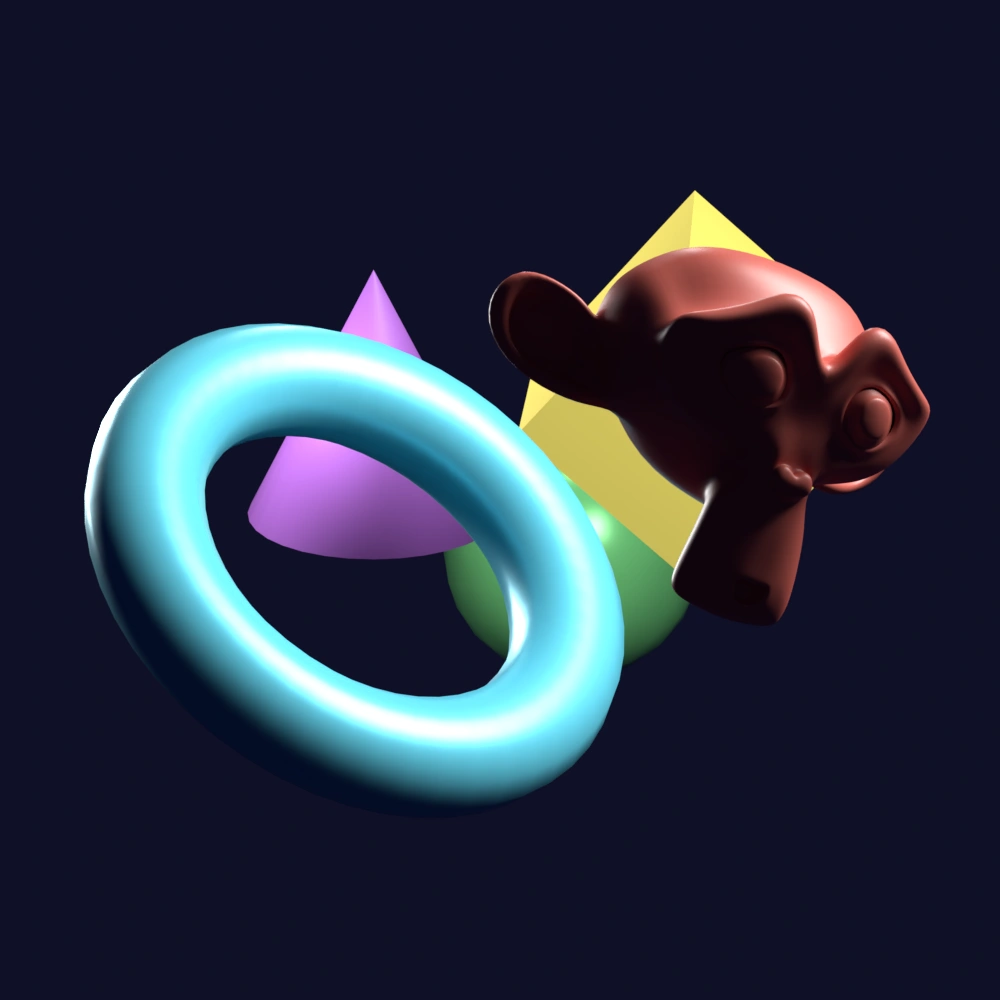
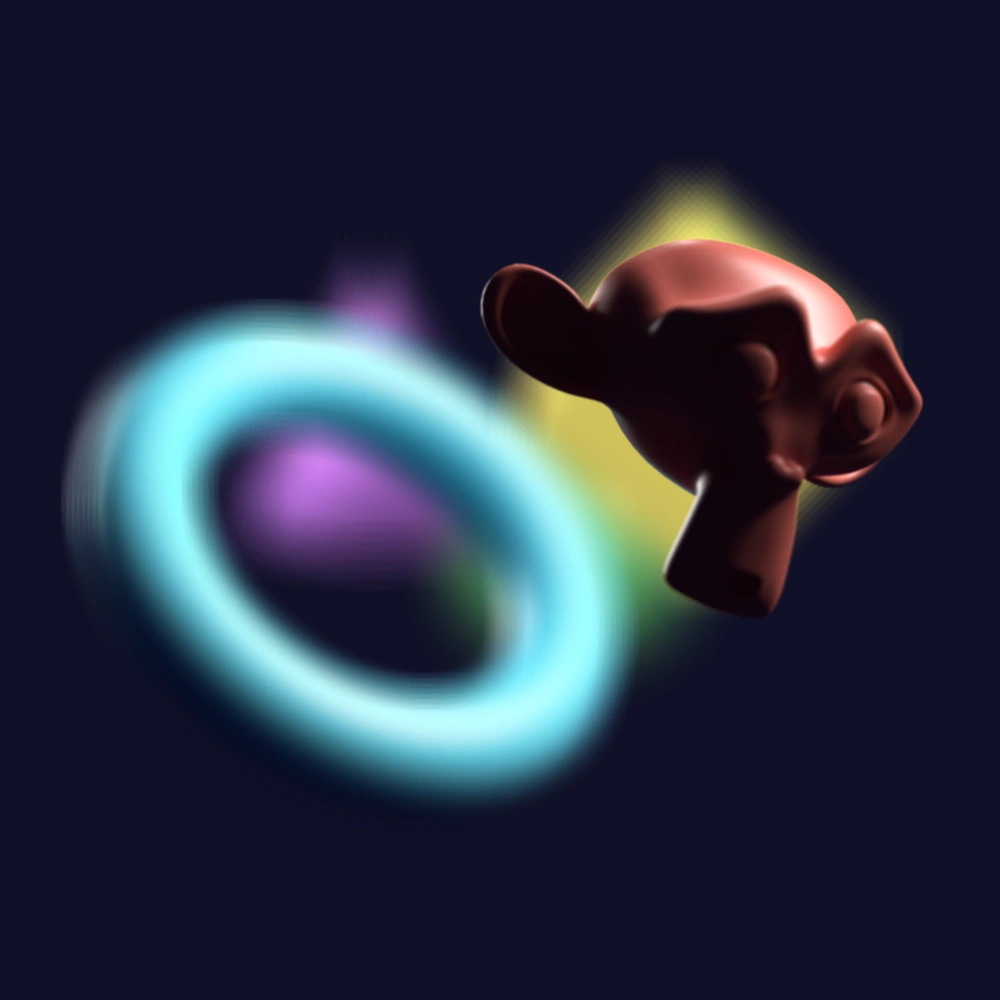
시점마다 1920×1080으로 렌더링해 물체 둘레 1000×1000 영역을 축소 없이 씁니다(휴대폰은 500×500, 논문은 6×6). 재구성은 64장을 거리만큼 밀어 평균한 것으로, 0.36–1.55 m를 31단계로 미리 계산했습니다. 만지기 전까지는 저절로 움직이고, 마우스나 막대를 쓰면 그 자리에서 멈춥니다.
문제
렌즈 배열 카메라는 센서 픽셀을 렌즈 수와 렌즈당 픽셀 수로 나눠 씁니다. 렌즈를 많이 두면 깊이 정보는 풍부해지지만, 렌즈 하나가 만드는 요소 영상은 몇 픽셀 크기로 작아집니다. 그대로는 사람이 보기에도, 검출 모델에 넣기에도 해상도가 부족합니다.
렌즈 배열에서 렌즈 하나와 그 뒤의 센서 칸은 아주 작은 카메라처럼 동작합니다. 한 점에서 나온 빛은 여러 렌즈를 지나 렌즈마다 아래의 다른 자리(픽셀)에 닿습니다. 렌즈 번호는 빛이 지난 위치, 렌즈 안 픽셀 자리는 빛이 들어온 방향입니다. 그래서 요소 영상 한 장에는 위치와 방향이 함께 담깁니다.
렌즈 배열은 무엇을 기록하나
RIM: 광선 기반 역매핑
요소 영상의 각 픽셀을 가상 렌즈 배열로 다시 내보내고 가상 카메라로 다시 찍는다고 보면, 텔레센트릭 촬영과 정사영 재촬영 조건에서 (렌즈 번호, 렌즈 안 픽셀 위치)가 (렌즈 안 픽셀 위치, 렌즈 번호)로 자리를 맞바꾸는 일대일 대응이 됩니다. 보간이 없어 양자화 오차가 0이고, 렌즈 수만큼의 해상도를 가진 시점 영상이 렌즈당 픽셀 수만큼 생깁니다. 논문에서는 이 결과를 컴퓨터 집적영상 재구성(CIIR)의 앞 단계로 씁니다.
결과
Stanford Lytro 라이트필드 7개 장면. 논문 기재값입니다.
| 처리 | PSNR (dB) | SSIM | mAP50 |
|---|---|---|---|
| 요소 영상 → CIIR | 23.31 | 0.741 | 0.665 |
| RIM → CIIR (제안) | 25.70 | 0.877 | 0.776 |
iRIM: 다시점 영상으로 가상 렌즈 배열 합성
RIM이 일대일 대응이므로 거꾸로도 쓸 수 있습니다. iRIM은 다시점 영상을 받아 원하는 가상 렌즈 배열의 요소 영상을 합성합니다. 논문에서는 24인치 FHD 패널에 맞춘 6×6 구성(렌즈 1.6056 mm, 320×180개)을 다뤘습니다.
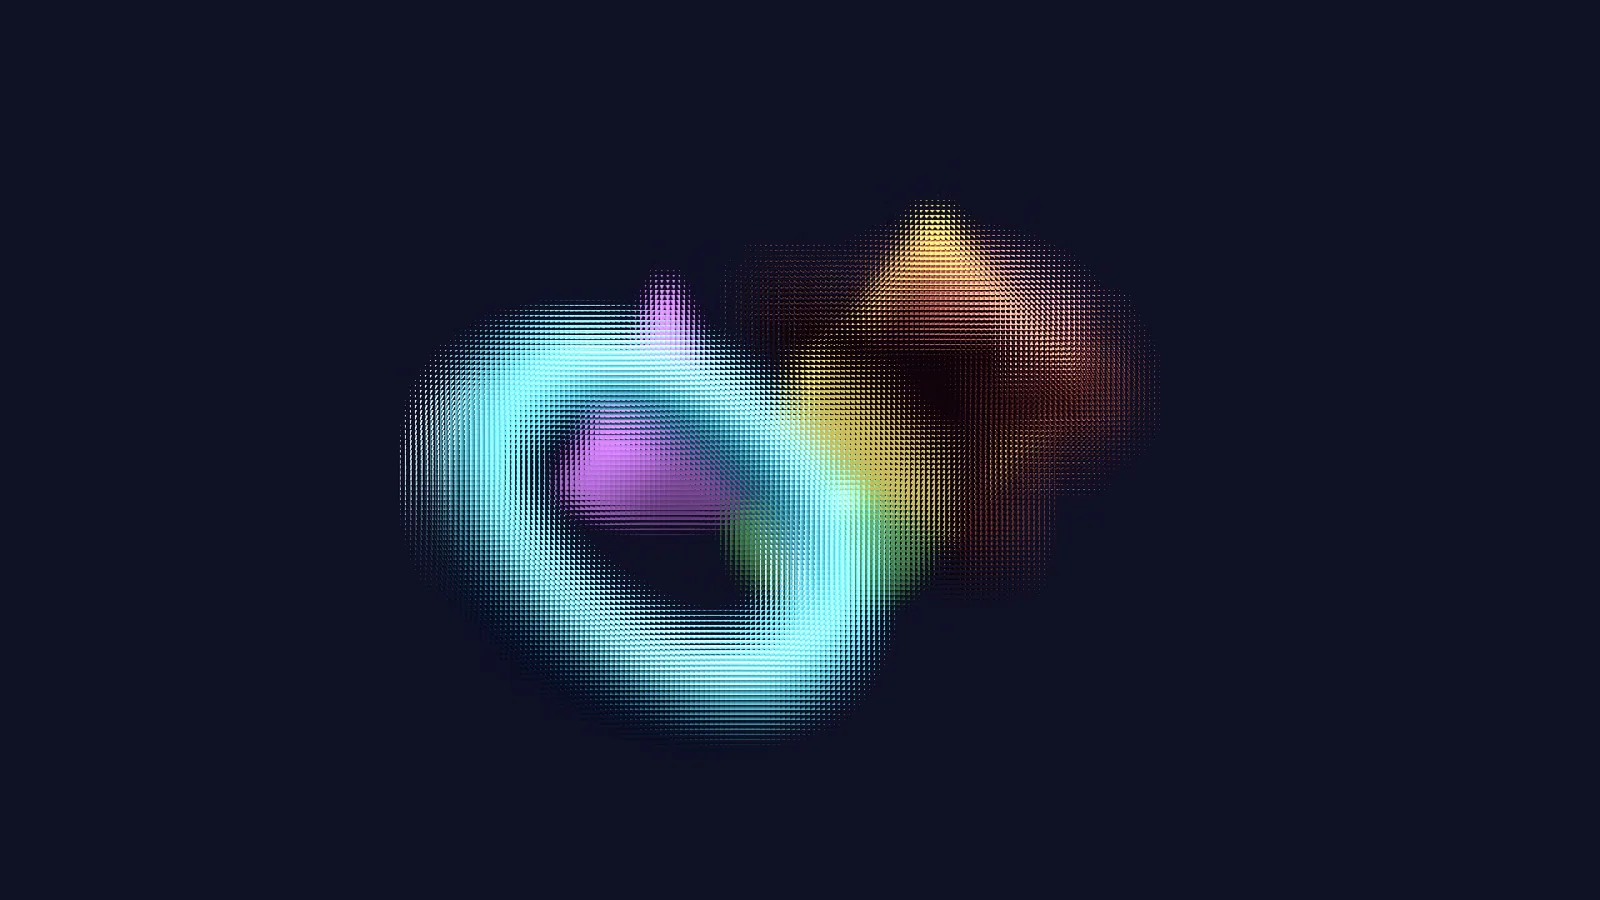
같은 블렌더 장면으로 만든 시점 영상 격자 비교. ICCAS 2026
연구 페이지의 실험실은 어떻게 만들었나
실험실은 렌즈 배열 촬영, RIM 재배열, 재구성을 브라우저에서 그대로 계산해 보여 줍니다. 끝나면 재구성 면을 정면에서 크게 보여 주고, 물체를 누르면 그 깊이로 초점을 옮깁니다. 실험실 열기 →
- 3D 장면: ICCAS 2026 논문의 블렌더 장면에서 내보낸 원숭이 머리와 원환체를 실제 3D 모델로 놓고, 렌즈 배열 촬영을 브라우저에서 계산합니다. 이 실험실의 핀홀 모델에서는 모든 렌즈의 같은 자리 픽셀이 같은 방향을 보므로, 시점 하나는 장면을 비스듬히 평행 투영한 영상입니다. 8×8 시점을 이렇게 그려 시점 영상과 깊이를 만들고, 재배열과 재구성은 그 데이터로 계산합니다. 앞의 원숭이 머리가 원환체 일부를 가리도록 놓았습니다. 공간 해상도는 64×64 렌즈입니다. 결과 화면에서 물체를 누르면, 누른 자리 둘레의 가운데 시점 4장의 깊이 값(중앙값)으로 초점을 옮깁니다.
- 촬영: 핀홀 배열 모델입니다. 요소 영상 픽셀 하나하나를 그 픽셀이 기록한 점의 3D 위치에 놓았다가 렌즈를 지나 센서로 옮깁니다. 1단계의 카메라 모형은 렌즈 하나와 그 뒤의 센서 칸이 작은 카메라라는 것을 보여 주는 그림으로, 보이도록 실제 렌즈보다 크게 그렸습니다.
- 재배열과 재구성: (렌즈 번호, 렌즈 안 위치)를 맞바꾸는 RIM과, 시점 영상을 거리만큼 밀어 평균하는 재구성은 논문 방식 그대로입니다. 거리가 물체의 깊이와 맞으면 그 물체의 표본이 원래 자리로 돌아와 선명해집니다. 2단계에서 시점 하나를 크게 보여 줄 때는 시점마다 영상을 렌즈 단위로 통째로 옮겨, 장면 뒤쪽의 한 면에 맞춰 보여 줍니다. 렌즈 배열의 시점 영상은 렌즈 배열 면에 맞춰져 있어 먼 물체일수록 크게 움직이지만, 이렇게 맞추면 달을 바라볼 때처럼 배경이 멈추고 가까운 물체일수록 크게 움직입니다. 값은 바꾸지 않고 위치만 옮깁니다.
- Lytro 예시: Stanford Lytro Light Field Archive(A. S. Raj, M. Lowney, R. Shah, G. Wetzstein, 2016)의 occlusions_26 장면입니다. 아카이브의 렌즈릿 영상은 센서 원본이 아니라 Lytro 소프트웨어가 디모자이크·정렬·재표본화·왜곡 보정을 마친 영상으로, 541×376개 렌즈마다 14×14 픽셀이 있습니다. 나뭇가지가 정지 표지판을 가리는 부분의 렌즈 128×128개를 재표본화 없이 잘라 가운데 8×8 픽셀(= 8×8 시점)을 씁니다. 재배열은 값을 바꾸지 않고 위치만 옮기고, 재구성은 64개 시점을 평행이동해 평균한 계산 결과입니다. "추정 깊이 층"은 같은 64개 시점으로 계산한 평면 스윕의 일치도로, 측정한 3D가 아니며 깊이 축은 미터가 아니라 시차(px/시점)입니다. 이 데이터에는 명시된 라이선스가 없어, 출처를 밝히고 일부만 잘라 비상업적 시연에 씁니다.
- 소리: 음악, 효과음, 로봇 목소리는 모두 브라우저가 직접 합성합니다.
두 논문의 코드는 비공개 저장소에 정리되어 있습니다(테스트 13개).